Googlebot : comprendre son impact SEO et l’optimiser 🚀🔥
Googlebot explore votre site avec un budget de crawl limité, et chaque erreur technique gaspille cette ressource précieuse au détriment de vos pages stratégiques. Sur un e-commerce ou un média à fort volume, une mauvaise gestion du crawl se traduit par des pages jamais indexées, des positions perdues et un trafic organique en chute. Voici comment identifier les failles qui bloquent Googlebot et les corriger méthodiquement.
- Budget de crawl maîtrisé : vos pages à forte valeur ajoutée sont explorées en priorité, pas les filtres ou paramètres inutiles.
- Indexation complète : chaque page importante est découverte, rendue et indexée sans erreur de rendu JavaScript.
- Ressources serveur préservées : Googlebot ne sature plus votre infrastructure avec des requêtes redondantes.
- Visibilité mesurable : l’analyse des logs serveur révèle précisément où le crawl se perd.
Les erreurs techniques qui gaspillent votre budget de crawl
Chaque requête de Googlebot compte : une boucle de redirection ou une page lente consomme le même budget qu’une page stratégique, mais sans aucun bénéfice pour votre classement.
| Faille technique | Impact sur Googlebot | Conséquence SEO |
|---|---|---|
| Chaînes de redirections 301 (3+ hops) | Googlebot abandonne le suivi après plusieurs redirections | Pages finales jamais indexées, autorité diluée |
| Boucles de redirection infinies | Crawl bloqué sur une URL, erreur “redirect loop” | Page totalement exclue de l’index |
| TTFB supérieur à 600 ms | Ralentit l’exploration de tout le site | Budget de crawl réduit, pages profondes ignorées |
| Pages orphelines | Découvertes uniquement via sitemap, jamais via liens | Exploration aléatoire, indexation retardée |
| Rendu JavaScript bloqué | Googlebot Smartphone ne voit pas le contenu dynamique | Pages vides indexées, contenu invisible |
| Paramètres d’URL non gérés | Crawl de milliers de variantes inutiles (tri, filtre, session) | Budget gaspillé, contenu dupliqué |
Votre site présente l’une de ces failles ? Demandez un diagnostic complet de votre crawl avant que vos positions ne se dégradent davantage.
Analyser les logs serveur pour comprendre le comportement de Googlebot
L’analyse des logs serveur est la seule méthode fiable pour voir exactement quelles URL Googlebot explore, à quelle fréquence, et où il rencontre des erreurs.
- Fréquence de crawl par section : identifiez les zones sur-explorées (paramètres, filtres) et sous-explorées (pages produits stratégiques).
- Code de réponse HTTP : repérez les 404, 500 et 301 qui consomment du budget sans valeur.
- User-Agent distinct : Googlebot Smartphone (Mobile) et Googlebot Desktop explorent différemment — analysez les deux séparément.
- Patterns temporels : détectez les pics de crawl anormaux qui saturent votre serveur.
- Corrélation avec les mises à jour : vérifiez si une modification technique a réduit la fréquence d’exploration.
Cette analyse révèle aussi les pages orphelines : si Googlebot ne découvre une URL que via le sitemap, elle n’a aucun lien interne qui la soutient. Le maillage interne est la clé d’une exploration complète et hiérarchisée.
La prestation : audit et optimisation du crawl Googlebot
L’audit couvre l’ensemble du cycle d’exploration, de la découverte des URL jusqu’au rendu final, avec des corrections concrètes et mesurables.
| Mission | Description | Importance |
|---|---|---|
| Analyse des logs serveur | Extraction et traitement des logs pour cartographier le crawl réel de Googlebot | Révèle les patterns anormaux et les zones sous-explorées |
| Audit robots.txt et meta robots | Vérification des directives, détection des blocages involontaires de pages stratégiques | Un Disallow mal placé peut exclure tout un silo de l’index |
| Correction des redirections | Identification des chaînes 301, mise en place de redirections directes vers l’URL finale | Préserve l’autorité et accélère l’exploration |
| Optimisation du sitemap XML | Nettoyage des URL inutiles, priorisation des pages stratégiques, soumission dans Google Search Console | Guide Googlebot vers les contenus à forte valeur |
| Gestion des paramètres d’URL | Configuration dans Google Search Console, implémentation de balises canonical | Élimine le crawl de contenu dupliqué et inutile |
| Correction du rendu JavaScript | Audit du rendu Googlebot Smartphone, correction des erreurs de chargement des ressources | Garantit que le contenu dynamique est bien indexé |
Signaux qui doivent vous alerter immédiatement
Certains symptômes dans Google Search Console indiquent un problème de crawl qu’il faut traiter sans attendre.
- Pages découvertes mais non indexées : Googlebot trouve vos URL mais ne les juge pas assez importantes pour les indexer.
- Erreurs 404 en hausse : des liens internes pointent vers des pages supprimées, gaspillant le budget de crawl.
- Baisse soudaine du nombre de pages indexées : un problème technique global (robots.txt, noindex accidentel) est probable.
- Temps de réponse serveur en dégradation : un TTFB élevé réduit la fréquence d’exploration de tout le site.
- Rendu JavaScript incomplet : l’outil d’inspection d’URL montre une page vide ou partielle.
Ces signaux ne se corrigent pas avec du contenu supplémentaire. Ils exigent une intervention technique précise, faute de quoi vos concurrents captent le trafic que vous perdez.
Les bonnes pratiques pour un crawl efficace et durable
Une architecture technique propre permet à Googlebot de découvrir, explorer et indexer vos pages sans friction, même sur les sites à très fort volume.
| Zone | Action recommandée | Résultat attendu |
|---|---|---|
| robots.txt | Autoriser Googlebot sur les CSS/JS, bloquer uniquement les zones inutiles | Rendu complet, crawl ciblé sur le contenu utile |
| Maillage interne | Relier chaque page importante en moins de 3 clics depuis l’accueil | Découverte naturelle, hiérarchie claire |
| Sitemap XML | Inclure uniquement les URL indexables, à jour, sans paramètres | Exploration prioritaire des pages stratégiques |
| Canonical tags | Pointer vers l’URL de référence pour chaque variante dupliquée | Consolidation de l’autorité, suppression du contenu dupliqué |
| Rendu JavaScript | Utiliser le rendu côté serveur (SSR) ou la pré-rendu pour les contenus critiques | Googlebot voit le contenu sans exécution complexe |
| Vitesse serveur | Optimiser le TTFB sous 200 ms, utiliser un CDN et la mise en cache | Exploration plus rapide, budget de crawl préservé |
Ces optimisations s’inscrivent dans une stratégie SEO globale. Un consultant SEO e-commerce saura prioriser ces actions selon votre volume de pages et votre concurrence. Pour les sites à fort trafic, la gestion du budget de crawl est un levier de croissance souvent sous-exploité.
Questions fréquentes
Comment savoir si Googlebot explore correctement mon site ?
Consultez le rapport “Statistiques d’exploration” dans Google Search Console et analysez vos logs serveur. Une fréquence de crawl stable ou croissante sur les pages stratégiques est un bon signe.
Quelle est la différence entre Googlebot Smartphone et Desktop ?
Googlebot Smartphone explore le web avec un user-agent mobile et un viewport réduit. Il est utilisé par défaut pour l’indexation mobile-first depuis 2019. Desktop ne sert plus qu’à des cas spécifiques.
Pourquoi Googlebot indexe-t-il des pages que je ne veux pas voir dans Google ?
Cela vient souvent de paramètres d’URL non gérés, de liens internes vers des pages techniques, ou d’absences de balises noindex ou canonical. L’audit des logs et du sitemap permet d’identifier ces fuites.
Combien de temps Googlebot met-il pour explorer une nouvelle page ?
De quelques heures à plusieurs semaines selon la qualité du maillage interne, la fréquence de mise à jour du site et le budget de crawl alloué. Un sitemap à jour et des liens internes depuis des pages populaires accélèrent le processus.
Le fichier robots.txt peut-il bloquer Googlebot sur tout mon site ?
Oui, une directive Disallow: / bloque l’exploration de tout le domaine. Vérifiez toujours votre robots.txt après une modification, car une erreur peut dé-indexer l’intégralité de votre site.
José Perez, consultant SEO indépendant depuis 2007, auteur d’un livre de référence sur le SEO e-commerce. Fort de 19 ans d’expérience sur des sites à fort volume, il intervient sur les problématiques de crawl, d’indexation et de visibilité dans les moteurs de recherche et l’IA générative. Découvrez comment mesurer votre visibilité dans l’IA.
Et le GEO ? Le référencement ne se joue plus seulement sur Google : le GEO (Generative Engine Optimization) rend vos contenus citables par ChatGPT, Gemini et les AI Overviews. Découvrir mon accompagnement GEO.
Résultats vérifiables
La preuve par les chiffres
Voici l'évolution réelle du trafic organique de sites que j'accompagne, mesurée par Semrush. Pas de promesses : des courbes.
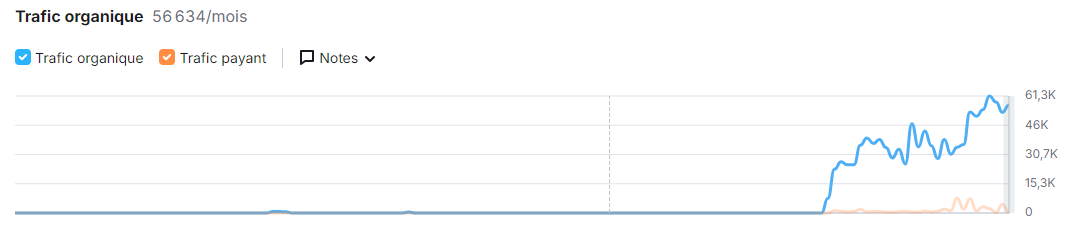
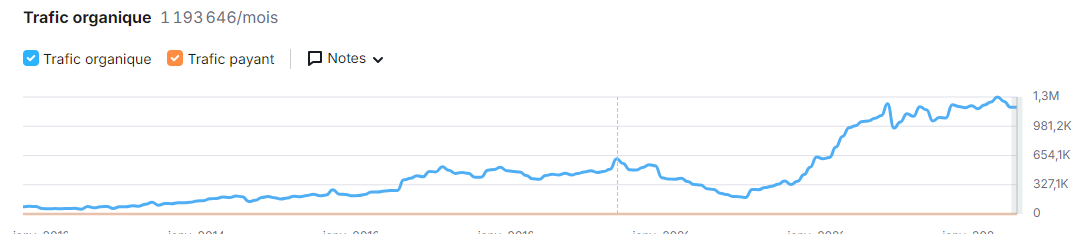
+1,2M
de visites organiques mensuelles générées
×3
de croissance sur un site déjà établi
0 €
de publicité : 100 % trafic organique
Captures Semrush disponibles sur demande, données anonymisées par respect de mes clients.
Analyse personnalisée, sans engagement, réponse sous 24 h, diagnostic gratuit sous 48 h avec 3–5 quick wins concrets.
Plus de 150 entrepreneurs m’ont déjà fait confiance
🔒 Vos données ne sont jamais partagées avec des tiers


José Perez, consultant SEO indépendant basé près de Rennes (Ille-et-Vilaine) depuis 2007, spécialisé en SEO technique et e-commerce. Il intervient en Bretagne et partout en France.
Tous les articles de José PEREZ →