Pourquoi mon site n’apparaît-il pas sur Google ? Découvrez pourquoi
Votre site internet est en ligne, mais impossible de le trouver sur Google ? Cette situation frustrante est souvent due à des blocages techniques précis, plutôt qu’à un manque de contenu. Identifions ensemble les causes les plus fréquentes et les solutions concrètes pour que votre site apparaisse enfin dans les résultats de recherche.
L’essentiel à retenir pour un diagnostic rapide
Pour déterminer pourquoi votre site reste invisible, concentrez-vous sur ces quatre piliers :
- Vérification de l’indexation : La commande `site:votre-domaine.com` est votre premier réflexe pour savoir si Google a enregistré vos pages.
- Contrôle des blocages techniques majeurs : Les fichiers `robots.txt` et les balises `noindex` sont les coupables les plus fréquents.
- Analyse de Google Search Console : Cet outil gratuit de Google est une mine d’informations sur la manière dont le moteur de recherche perçoit et explore votre site.
- Optimisation de la structure et du contenu : Corrigez les chaînes de redirection et le contenu dupliqué qui diluent l’autorité de vos pages et freinent leur classement.
Les leviers prioritaires pour une progression rapide et visible
Avant de penser à la production de contenu, assurez-vous que Google peut techniquement accéder à vos pages. Un site au contenu exceptionnel mais bloqué par une directive technique restera invisible. Voici les points de contrôle essentiels, classés par leur impact potentiel sur votre visibilité.
| Levier de diagnostic | Action de contrôle | Impact sur la visibilité | Solution rapide |
|---|---|---|---|
| Indexation (commande `site:`) | Lancer `site:votre-domaine.com` dans Google | Confirme si le problème est global ou page par page. Un résultat vide indique un blocage majeur. | Si vide, passer aux vérifications `robots.txt` et `noindex`. |
| Fichier `robots.txt` | Vérifier qu’il ne bloque pas les sections importantes (CSS, JS, pages clés) | Un blocage total (`Disallow: /`) empêche toute exploration du site. | Supprimer ou restreindre la directive `Disallow: /` si elle est trop large. |
| Balises `meta noindex / nofollow` | Inspecter le code source des pages stratégiques (clic droit → “Afficher la source”) | Une balise `noindex` retire spécifiquement la page de l’index de Google. | Supprimer la balise `noindex` des pages à indexer. |
| Sitemap XML | Soumettre le fichier dans Google Search Console | Accélère la découverte des nouvelles pages par Googlebot. | Générer un sitemap et le soumettre via GSC. |
| Redirections (301, chaînes) | Auditer les chaînes de redirection avec un outil de crawl (ex: Screaming Frog) | Les chaînes longues gaspillent le budget de crawl et diluent la valeur des liens (PageRank). | Mettre en place des redirections directes (301) vers la bonne URL finale. |
| Performance et HTTPS | Tester la vitesse de chargement (PageSpeed Insights) et la validité du certificat SSL | Un site lent ou non sécurisé (HTTP) est dépriorisé par Google. | Optimiser la vitesse du site et s’assurer d’un certificat SSL valide. |
Votre site présente l’un de ces blocages ? Un diagnostic complet de votre référencement est souvent nécessaire pour identifier la cause exacte et mettre en place les corrections.
1. Vérifier l’indexation avec la commande `site:` : le premier réflexe
La commande `site:votre-domaine.com` est le test le plus rapide. Tapez-la directement dans la barre de recherche Google.
- Si le résultat est vide : Votre site est totalement absent de l’index de Google. C’est le signe d’un blocage majeur. Concentrez-vous immédiatement sur les fichiers `robots.txt` et les balises `noindex`.
- Si le résultat est partiel : Seules certaines de vos pages sont indexées. Identifiez les pages manquantes et utilisez Google Search Console pour rechercher des erreurs de couverture spécifiques à ces pages.
- Si le résultat affiche des pages obsolètes ou incorrectes : Google indexe d’anciennes URL ou des versions non souhaitées de vos pages. Vérifiez vos redirections (301) et la structure de vos URLs pour guider Google vers le bon contenu.
2. Le fichier `robots.txt` : le gardien de l’exploration
Le fichier `robots.txt`, situé à la racine de votre domaine (ex: `votre-domaine.com/robots.txt`), est une directive pour les robots des moteurs de recherche. Il leur indique quelles parties de votre site ils peuvent ou ne peuvent pas explorer.
Une erreur courante est une directive `Disallow: /` qui bloque l’intégralité du site. Cela arrive souvent après une migration, lors de la mise en ligne d’un nouveau site ou via une mauvaise configuration d’un plugin WordPress.
Erreurs courantes de `robots.txt` et leurs conséquences
- `Disallow: /` : Bloque l’exploration de tout le site. Conséquence : Googlebot ne peut pas accéder à vos pages. Correction : Supprimez cette directive ou restreignez-la à des dossiers spécifiques (ex: `Disallow: /wp-admin/`).
- Blocage des fichiers CSS/JS : Si Google ne peut pas accéder à vos feuilles de style (CSS) ou scripts JavaScript (JS), il ne peut pas “rendre” votre page correctement. Il voit une page sans mise en forme, ce qui peut nuire à son évaluation de la qualité et de l’expérience utilisateur. Correction : Assurez-vous que les répertoires contenant ces ressources sont autorisés (ex: `Allow: /wp-content/`).
- Directives obsolètes après une migration : Si vous avez changé la structure de vos URLs, un ancien `robots.txt` peut empêcher l’exploration des nouvelles. Correction : Mettez à jour le fichier avec les nouvelles règles et testez-le via l’outil de test du `robots.txt` dans Google Search Console.
3. Les balises `meta noindex` et `nofollow` : des exclusions volontaires (ou non)
Une balise `meta name=”robots” content=”noindex”` placée dans la section `
` du code HTML d’une page indique à Google de ne pas l’indexer. La page sera explorée, mais ne figurera pas dans les résultats de recherche.Une balise `meta name=”robots” content=”nofollow”` indique à Google de ne pas suivre les liens présents sur cette page, ni de transmettre de “jus de lien” (PageRank) aux pages liées.
Comment vérifier et corriger les balises `noindex`
- Vérifiez le code source : Sur vos pages stratégiques, faites un clic droit → “Afficher la source de la page” (ou “Inspecter l’élément”) et recherchez la chaîne “noindex”.
- Utilisez l’outil d’inspection d’URL de Google Search Console : Cet outil vous montrera exactement comment Google interprète la page, y compris la présence de balises `noindex`. Si la page est bloquée, GSC vous le signalera.
- Attention aux plugins SEO : Des plugins comme Yoast SEO ou Rank Math sur WordPress peuvent ajouter automatiquement des balises `noindex` sur certaines catégories de pages (archives, pages de tags, résultats de recherche interne) pour éviter le contenu dupliqué. Vérifiez les paramètres de votre plugin.
Si une page importante contient une balise `noindex` par erreur, supprimez-la du code HTML ou via les réglages de votre CMS/plugin SEO.
4. La soumission du sitemap XML à Google Search Console : guider Googlebot
Le sitemap XML est une liste de toutes les URLs de votre site que vous souhaitez voir indexées. Il ne garantit pas l’indexation, mais il aide Google à découvrir vos pages, surtout pour un nouveau site ou après une refonte majeure.
Étapes clés pour la soumission d’un sitemap XML
- 1. Générer le sitemap : Utilisez un plugin SEO (pour WordPress) ou un générateur en ligne. Assurez-vous que le fichier est au format XML et qu’il inclut toutes les pages importantes.
- 2. Vérifier l’accessibilité : L’URL de votre sitemap (ex: `votre-domaine.com/sitemap.xml`) doit être accessible publiquement et ne doit pas être bloquée par votre `robots.txt`.
- 3. Soumettre dans Google Search Console : Accédez à la section “Sitemaps” de GSC, entrez l’URL de votre sitemap et cliquez sur “Envoyer”. Surveillez le statut ; il devrait passer à “Réussi” après quelques jours.
5. Les erreurs techniques qui freinent Googlebot : serveur, HTTPS et vitesse
Au-delà des directives explicites, des problèmes techniques plus profonds peuvent empêcher Googlebot d’explorer et d’indexer efficacement votre site.
Erreurs serveur (codes 5xx) et erreurs client (codes 4xx)
- Erreurs 500 (Internal Server Error) : Indiquent un problème côté serveur. Googlebot ne peut pas accéder à la page. Corrigez les problèmes de configuration serveur, de base de données ou de code. Google Search Console signale ces erreurs dans la section “Erreurs d’exploration”.
- Erreurs 404 (Page non trouvée) : Indiquent que la page n’existe plus. Si ces erreurs concernent des pages importantes ou sont trop nombreuses, cela peut signaler un site mal entretenu à Google. Mettez en place des redirections 301 pour les pages supprimées ou déplacées, et corrigez les liens internes brisés.
HTTPS obligatoire
Google a clairement indiqué que le HTTPS (protocole sécurisé) est un facteur de classement. Un site en HTTP est non seulement moins sécurisé pour vos utilisateurs, mais il est aussi dépriorisé dans les résultats de recherche.
- Vérifiez votre certificat SSL : Assurez-vous qu’il est valide et correctement configuré.
- Redirigez tout le trafic HTTP vers HTTPS : Une redirection 301 permanente doit être mise en place pour forcer l’accès sécurisé.
Temps de chargement excessif
La vitesse de chargement est un facteur de classement crucial, en particulier sur mobile. Un site lent frustre les utilisateurs et épuise le “budget de crawl” de Googlebot, qui passera moins de temps à explorer vos pages.
- Testez avec Google PageSpeed Insights : Identifiez les points à améliorer (optimisation des images, mise en cache, réduction des requêtes, etc.).
- Choisissez un hébergement performant : Un hébergeur de qualité est la base d’un site rapide.
6. Contenu dupliqué et chaînes de redirection : diluer l’autorité
Même si Google explore vos pages, d’autres problèmes peuvent empêcher leur bon classement.
Le contenu dupliqué
Le contenu dupliqué, qu’il soit interne (plusieurs URLs pour le même contenu sur votre site) ou externe (votre contenu présent sur d’autres sites), peut diluer l’autorité de vos pages et rendre difficile pour Google de déterminer quelle version indexer et classer.
- Utilisez les balises canoniques : La balise `` indique à Google quelle est la version préférée d’une page.
- Évitez la duplication interne : Configurez votre CMS pour éviter que des pages d’archives, de tags ou de pagination ne génèrent du contenu dupliqué.
Les chaînes de redirection
Une chaîne de redirection se produit lorsqu’une URL redirige vers une seconde, qui redirige elle-même vers une troisième, et ainsi de suite. Par exemple : `page-A` → `page-B` → `page-C`.
- Impact SEO : Chaque redirection fait perdre une petite partie de l’autorité (environ 10% par saut). Les chaînes longues gaspillent le budget de crawl et affaiblissent le signal SEO.
- Correction : Mettez en place des redirections 301 directes de l’ancienne URL vers l’URL finale. Utilisez un outil de crawl pour identifier et corriger ces chaînes.
En vous concentrant sur ces points techniques, vous mettez toutes les chances de votre côté pour que votre site soit enfin visible sur Google. Une fois ces fondations solides, vous pourrez alors pleinement vous consacrer à votre stratégie de contenu et de netlinking.
Le SEO a désormais un complément, le GEO (Generative Engine Optimization), qui vise à faire recommander votre site par les moteurs de réponse IA. Comprendre le GEO.
Résultats vérifiables
La preuve par les chiffres
Voici l'évolution réelle du trafic organique de sites que j'accompagne, mesurée par Semrush. Pas de promesses : des courbes.
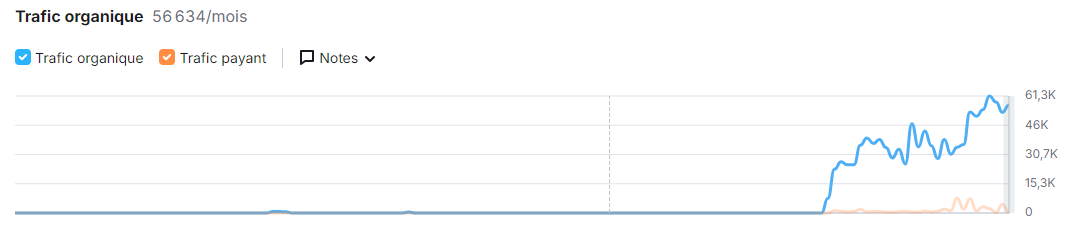
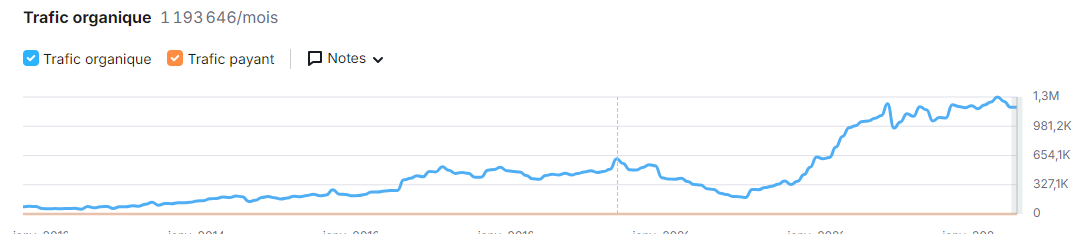
+1,2M
de visites organiques mensuelles générées
×3
de croissance sur un site déjà établi
0 €
de publicité : 100 % trafic organique
Captures Semrush disponibles sur demande, données anonymisées par respect de mes clients.
Analyse personnalisée, sans engagement, réponse sous 24 h, diagnostic gratuit sous 48 h avec 3–5 quick wins concrets.
Plus de 150 entrepreneurs m’ont déjà fait confiance
🔒 Vos données ne sont jamais partagées avec des tiers


José Perez, consultant SEO indépendant basé près de Rennes (Ille-et-Vilaine) depuis 2007, spécialisé en SEO technique et e-commerce. Il intervient en Bretagne et partout en France.
Tous les articles de José PEREZ →