Référencement GEO : comment être cité par les IA
Le référencement GEO (Generative Engine Optimization) vise un objectif précis : faire citer votre contenu dans les réponses de ChatGPT, Gemini, Perplexity ou des AI Overviews de Google. Depuis le déploiement français du 22 juillet 2026, les sites très exposés ont perdu en moyenne 23,1 % de taux de clics en neuf jours, selon l’étude Ahrefs publiée le 17 août 2026. Voici la méthode et les étapes concrètes pour transformer votre site en source citée.
- Le GEO s’ajoute au SEO : les moteurs génératifs puisent dans les index de recherche classiques, sans indexation préalable aucune citation n’est possible.
- La méthode repose sur cinq chantiers séquencés : audit de citabilité, données structurées, accès des crawlers IA, réécriture extractible, publication de données exclusives.
- L’unité de visibilité change : ce n’est plus la page classée, mais le passage auto-portant extrait par le LLM.
- La mesure se fait sur les citations, la part de voix et le trafic référent IA, plus seulement sur les positions Google.
La méthode GEO en 5 étapes concrètes
La prestation GEO se déroule en cinq étapes séquencées, de l’audit de citabilité à la publication de données exclusives, chacune avec des livrables vérifiables.
| Étape | Actions techniques | Livrable |
|---|---|---|
| 1. Audit de citabilité | Analyse des requêtes fan-out, test de 50 à 100 prompts sur ChatGPT, Gemini, Perplexity et AI Overviews, relevé des sources citées | Rapport de part de voix IA et liste des concurrents cités à votre place |
| 2. Données structurées | Déploiement Schema.org (Organization, LocalBusiness, FAQPage, HowTo, Product), validation Rich Results, cohérence des entités nommées | Fichier JSON-LD complet et mapping entités / Knowledge Graph |
| 3. Accès des crawlers IA | Contrôle du robots.txt (OAI-SearchBot, PerplexityBot, ClaudeBot, Google-Extended), création d’un llms.txt, vérification des logs serveur | robots.txt corrigé, llms.txt publié, rapport de crawl par robot |
| 4. Réécriture extractible | Réponse directe sous chaque H2/H3, découpage en passages auto-portants, tableaux sémantiques, statistiques sourcées | Contenus réécrits prêts pour le RAG et les featured snippets |
| 5. Données exclusives | Publication d’études, de benchmarks, de données propriétaires que le LLM ne trouve nulle part ailleurs | Contenu original citable et monétisable en mentions de marque |
Étape 1 : auditer votre citabilité actuelle dans les IA
L’audit de citabilité mesure votre présence réelle dans les réponses génératives avant toute optimisation, en testant des prompts représentatifs de votre marché.
- Sélectionner 50 à 100 prompts correspondant aux requêtes fan-out de votre secteur (questions décomposées, requêtes comparatives, requêtes locales).
- Tester chaque prompt sur ChatGPT, Gemini, Perplexity, Copilot et les AI Overviews de Google, en mode connecté et déconnecté.
- Relever systématiquement : sources citées, position de votre marque, formulation exacte reprise, présence ou absence de lien.
- Calculer votre part de voix IA (nombre de citations / nombre de prompts) et la comparer à celle de vos concurrents.
- Identifier les pages de votre site déjà citées, celles qui devraient l’être, et les sources tierces qui prennent votre place.
Ce diagnostic initial conditionne tout le reste. Sans lui, vous optimisez à l’aveugle. Pour cadrer cette phase, un audit GEO / LLM dédié permet de mesurer précisément votre visibilité actuelle dans les moteurs génératifs.
Étape 2 : structurer vos données pour les LLM
Les données structurées Schema.org permettent aux LLM d’identifier sans ambiguïté votre entité, vos services et vos zones d’intervention, ce qui conditionne leur capacité à vous citer.
| Schéma | Usage GEO | Impact sur la citation IA |
|---|---|---|
| Organization | Identité de marque, logo, réseaux, sameAs | Ancrage de l’entité nommée dans le Knowledge Graph |
| LocalBusiness | Adresse, zone desservie, horaires, géolocalisation | Reconnaissance pour les requêtes locales génératives |
| FAQPage | Questions-réponses structurées | Extraction directe en réponse à une sous-question fan-out |
| HowTo | Étapes numérotées d’un processus | Reprise du déroulé procédural dans une réponse générée |
| Product / Offer | Prix, disponibilité, avis | Citation dans les réponses transactionnelles comparatives |
| Person / Author | Auteur, expertise, publications | Signal E-E-A-T exploité pour la fiabilité de la source |
- Valider chaque balise avec le Rich Results Test et corriger les erreurs de propriétés obligatoires.
- Aligner les entités nommées (nom de marque, ville, service) entre le JSON-LD, le contenu visible et le Google Business Profile.
- Déclarer les liens sameAs vers les profils officiels pour consolider l’identité dans le Knowledge Graph.
- Éviter les schémas contradictoires : un LocalBusiness dont l’adresse diffère du NAP affiché pénalise la reconnaissance.
Étape 3 : ouvrir votre site aux crawlers IA
Les crawlers IA doivent pouvoir accéder à vos pages pour que vos contenus entrent dans les index utilisés par les moteurs génératifs.
| Moteur | Robot | Rôle |
|---|---|---|
| ChatGPT (OpenAI) | OAI-SearchBot | Indexation pour la recherche de ChatGPT |
| ChatGPT (OpenAI) | ChatGPT-User | Visite d’une page à la demande d’un utilisateur |
| OpenAI | GPTBot | Collecte pour l’entraînement des modèles |
| Google AI Overviews | Googlebot | Les réponses IA de Google s’appuient sur l’index de recherche classique |
| Google Gemini | Google-Extended | Contrôle l’usage de vos contenus pour Gemini, sans effet sur la recherche Google |
| Perplexity | PerplexityBot, Perplexity-User | Indexation et visites à la demande |
| Claude (Anthropic) | ClaudeBot, Claude-SearchBot, Claude-User | Entraînement, recherche, visites à la demande |
| Microsoft Copilot | Bingbot | S’appuie sur l’index Bing |
- Vérifier que le robots.txt n’interdit aucun de ces user-agents par une règle Disallow héritée d’un ancien blocage.
- Contrôler les logs serveur pour confirmer que les crawlers IA atteignent bien vos pages stratégiques et ne se font pas bloquer par un WAF ou un rate limiting.
- Publier un fichier llms.txt à la racine listant vos contenus de référence, pour orienter les LLM vers vos pages les plus citables.
- Distinguer les robots d’entraînement (GPTBot) des robots de recherche (OAI-SearchBot) : bloquer le premier n’empêche pas le second de vous indexer.
Bloquer Google-Extended ne vous retire pas des AI Overviews : ces réponses dépendent de Googlebot. Sortir des AI Overviews revient à sortir de Google, ce qui n’est pas une option viable pour la majorité des sites.
Étape 4 : réécrire pour l’extraction RAG et le fan-out
Un contenu extractible répond à une question dès sa première phrase, sans dépendre du contexte des paragraphes précédents.
- Placer une réponse directe de 20 à 35 mots immédiatement sous chaque titre H2 et H3.
- Découper chaque section en passages auto-portants : un paragraphe = une question = une réponse complète.
- Remplacer les blocs narratifs par des tableaux sémantiques et des listes à puces, formats que les LLM parsent sans ambiguïté.
- Intégrer des statistiques sourcées et des citations d’autorité, deux des leviers les mieux documentés par la recherche GEO.
- Nommer explicitement les entités (villes, services, technologies) pour renforcer la co-occurrence sémantique.
Étape 5 : publier des données exclusives
Un LLM cite en priorité ce qu’il ne trouve nulle part ailleurs : données propriétaires, benchmarks, études originales.
- Publier des études internes (taux de conversion, prix moyens, volumes de recherche observés) que personne d’autre ne détient.
- Diffuser des benchmarks sectoriels datés, avec méthodologie et taille d’échantillon explicites.
- Produire des comparatifs chiffrés issus de vos propres tests, pas de reprises d’études tierces.
- Signer chaque publication d’un auteur identifiable, avec parcours et expertise vérifiables.
Checklist : les signaux qui doivent alerter
Ces indicateurs révèlent un déficit de citabilité IA avant même que le trafic ne chute.
- Vos pages n’apparaissent dans aucune réponse ChatGPT, Gemini ou Perplexity sur vos requêtes métier.
- Votre robots.txt bloque un crawler IA sans décision stratégique documentée.
- Aucune balise Schema.org Organization ou LocalBusiness n’est déployée sur le site.
- Vos paragraphes d’introduction dépassent 60 mots avant de répondre à la question posée.
- Votre Google Business Profile affiche un NAP incohérent avec le contenu du site.
- Vos concurrents sont cités à votre place sur des requêtes où vous êtes mieux classé dans Google.
- Vous ne mesurez ni part de voix IA, ni trafic référent issu des moteurs génératifs.
FAQ
Combien de temps avant de voir des citations IA ?
Les premiers effets sur les crawlers et l’indexation apparaissent en deux à quatre semaines. Les citations dans les réponses génératives se stabilisent généralement entre deux et quatre mois, selon la fréquence de rafraîchissement des index utilisés par chaque moteur.
Faut-il bloquer les crawlers IA pour protéger son contenu ?
Bloquer GPTBot empêche l’entraînement mais pas la recherche ChatGPT, qui dépend d’OAI-SearchBot. Bloquer Google-Extended n’a aucun effet sur les AI Overviews. La décision se prend crawler par crawler, selon votre modèle économique.
Le GEO remplace-t-il le SEO local ?
Non. Le SEO local alimente le pack Maps et le Google Business Profile, dont les signaux (NAP, avis, citations locales) nourrissent aussi les réponses génératives locales. Les deux disciplines se renforcent mutuellement.
Comment mesurer sa visibilité dans les IA ?
On suit trois indicateurs : la part de voix IA (citations / prompts testés), les mentions de marque dans les réponses générées, et le trafic référent identifié comme provenant de ChatGPT, Perplexity ou Gemini dans les analytics.
Pour maximiser vos chances d’être cité, il est essentiel d’optimiser spécifiquement votre visibilité dans Perplexity et Gemini, qui sont des acteurs majeurs de la recherche générative.
Comprendre l’impact des AI Overviews en France et savoir comment adapter votre stratégie SEO est devenu indispensable pour maintenir votre visibilité.
L’auteur
José Perez — consultant SEO indépendant depuis 2007 (19 ans d’expérience). Auteur d’un livre de référence sur le SEO e-commerce. Il accompagne des sites sur les volets technique, contenu et notoriété, et documente ses méthodes sur Fuck You Money Club. Pour un accompagnement sur votre marché, consultez la page consultant SEO freelance à Paris ou la prestation webmarketing.
Résultats vérifiables
La preuve par les chiffres
Voici l'évolution réelle du trafic organique de sites que j'accompagne, mesurée par Semrush. Pas de promesses : des courbes.
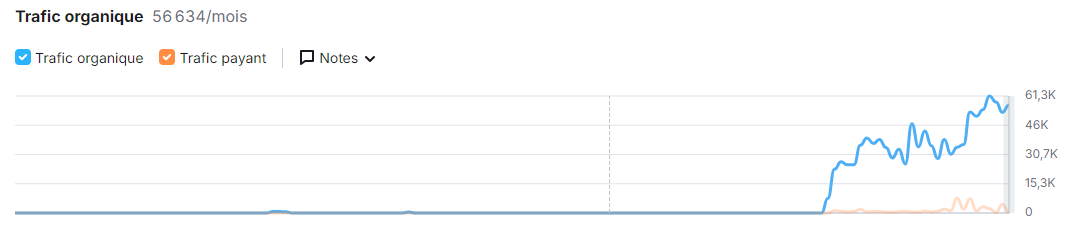
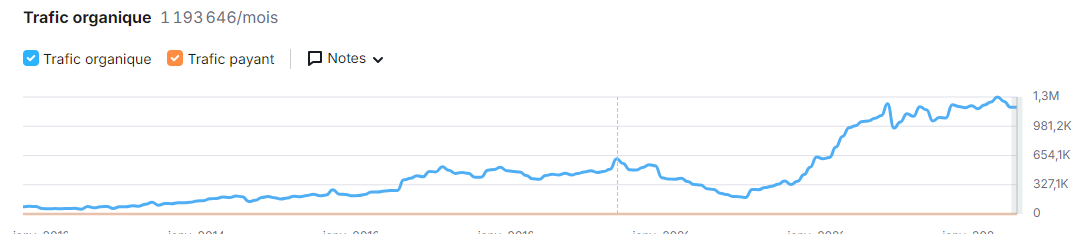
+1,2M
de visites organiques mensuelles générées
×3
de croissance sur un site déjà établi
0 €
de publicité : 100 % trafic organique
Captures Semrush disponibles sur demande, données anonymisées par respect de mes clients.
Analyse personnalisée, sans engagement, réponse sous 24 h, diagnostic gratuit sous 48 h avec 3–5 quick wins concrets.
Plus de 150 entrepreneurs m’ont déjà fait confiance
🔒 Vos données ne sont jamais partagées avec des tiers


José Perez, consultant SEO indépendant basé près de Rennes (Ille-et-Vilaine) depuis 2007, spécialisé en SEO technique et e-commerce. Il intervient en Bretagne et partout en France.
Tous les articles de José PEREZ →