Indexée malgré le blocage du fichier robots.txt : que faire ?
Une page bloquée par le fichier robots.txt mais pourtant indexée par Google est un signal d’alarme technique majeur pour votre SEO. Ce statut, affiché dans Google Search Console comme « Indexée malgré le blocage par le fichier robots.txt », indique que Google a découvert l’URL par un autre moyen que le crawl direct, sans pour autant pouvoir la parcourir pour en comprendre le contenu. Il est crucial d’agir pour maîtriser votre indexation et éviter les problèmes de qualité.
L’essentiel à retenir sur robots.txt et l’indexation
- Le fichier robots.txt ne contrôle que l’exploration (crawl) de votre site par les robots des moteurs de recherche, pas son indexation.
- Une page peut être indexée même si elle est bloquée par robots.txt, notamment si elle reçoit des liens externes (backlinks) ou internes.
- La seule méthode fiable pour empêcher l’indexation d’une page est l’utilisation de la balise
<meta name="robots" content="noindex">ou de l’en-tête HTTPX-Robots-Tag: noindex. - Des liens internes pointant vers des pages bloquées par robots.txt peuvent annuler l’effet de votre directive Disallow. Vous devez les supprimer ou y ajouter l’attribut
rel="nofollow". - L’outil de suppression d’URL de Google Search Console offre une solution temporaire pour désindexer rapidement une page, mais ne résout pas la cause profonde du problème.
Comprendre la nuance : blocage du crawl vs. blocage de l’indexation
La confusion entre les directives Disallow de robots.txt et noindex est la cause principale de ce type de problème. Un fichier robots.txt configuré avec User-agent: * et Disallow: /admin/ empêche Googlebot d’accéder aux pages du répertoire /admin/. Cependant, si une page de ce répertoire reçoit un lien depuis un autre site web, Google peut l’indexer sans jamais avoir pu en explorer le contenu. Résultat : une page indexée avec un snippet vide ou générique, qui ne reflète pas son contenu réel et peut nuire à votre image de marque.
La balise <meta name="robots" content="noindex">, placée dans la section <head> d’une page HTML, est le signal explicite qui interdit à Google d’indexer cette page après l’avoir explorée. C’est la seule garantie d’une désindexation effective.
Tableau comparatif des directives de crawl et d’indexation
| Directive | Effet sur le crawl (exploration) | Effet sur l’indexation | Cas d’usage |
|---|---|---|---|
Disallow dans robots.txt |
Bloque l’exploration de l’URL par les robots. | Aucun effet direct. La page peut être indexée si découverte via des liens. | Empêcher l’exploration de sections non publiques (ex: /wp-admin/, /panier/). |
<meta name="robots" content="noindex"> |
Aucun effet. La page est explorée normalement. | Empêche l’indexation de la page après exploration. | Désindexer des pages à faible valeur ajoutée (ex: pages de tags vides, résultats de recherche internes, pages de remerciement). |
X-Robots-Tag: noindex (en-tête HTTP) |
Aucun effet. La page est explorée normalement. | Empêche l’indexation, y compris pour les ressources non-HTML (PDF, images, vidéos). | Désindexer des fichiers spécifiques ou des types de contenu non-HTML. |
rel="nofollow" sur un lien |
Indique à Googlebot de ne pas suivre le lien. | Aucun effet direct sur l’indexation de la page cible si elle est découverte par d’autres moyens. | Ne pas transmettre de “jus SEO” ou ne pas cautionner le contenu de la page liée (ex: commentaires utilisateurs, liens publicitaires). |
Les causes profondes d’indexation malgré le blocage robots.txt
Google indexe une page bloquée par robots.txt lorsque l’URL est découverte par un canal alternatif au crawl direct. Identifier ces canaux est la clé pour résoudre le problème durablement.
- Backlinks externes non maîtrisés : Un lien pointant depuis un site tiers vers une URL que vous avez bloquée dans robots.txt permet à Google de connaître l’existence de cette page. Sans pouvoir l’explorer, Google peut tout de même l’indexer, affichant alors un résultat de recherche souvent vide ou avec un titre générique. C’est le scénario le plus courant.
- Liens internes “oubliés” : Si une page de votre propre site, accessible par Google, contient un lien vers une URL bloquée par robots.txt, vous annulez de fait votre directive Disallow. Googlebot peut découvrir la page via ce lien interne, même s’il ne peut pas l’explorer en raison du blocage.
- Sitemap XML mal configuré : Inclure des URL bloquées par robots.txt dans votre sitemap XML envoie des signaux contradictoires à Google. Le sitemap est censé lister les pages que vous souhaitez voir indexées. Si vous y placez des URL bloquées, Google peut tenter de les crawler et, potentiellement, de les indexer.
- Ressources non-HTML : Les fichiers PDF, les images ou les vidéos peuvent être indexés même si leur répertoire est bloqué par robots.txt. Pour ces types de ressources, la balise meta noindex n’est pas applicable. Il faut utiliser l’en-tête HTTP
X-Robots-Tag: noindex. - JavaScript rendu : Googlebot est capable d’exécuter le JavaScript. Si des URL sont générées dynamiquement via JavaScript et que ces URL sont bloquées dans robots.txt, Google peut tout de même les découvrir et les indexer si le rendu JavaScript révèle leur existence.
La méthode José Perez : diagnostic et correction du statut « Indexée malgré le blocage »
La résolution de ce problème suit un protocole rigoureux. En tant qu’expert SEO, je vous guide à travers les étapes pour identifier, corriger et désindexer ces pages de manière pérenne.
Étapes clés de la désindexation efficace
- Audit Google Search Console (GSC) :
- Accédez au rapport « Pages » dans GSC.
- Filtrez les pages par le statut « Indexée malgré le blocage par le fichier robots.txt ». Cette étape vous donnera une vue précise de l’ampleur du problème et des URL concernées.
- Analyse des canaux de découverte :
- Pour chaque URL identifiée, utilisez l’outil d’inspection d’URL de GSC. Regardez la section « Couverture » pour comprendre comment Google a découvert la page (via sitemap, liens, etc.).
- Vérifiez l’existence de backlinks externes pointant vers ces URL (via des outils comme Ahrefs, SEMrush, ou même GSC dans la section “Liens”).
- Identifiez les liens internes sur votre site qui pourraient pointer vers ces pages bloquées.
- Contrôlez votre sitemap XML pour vous assurer qu’aucune de ces URL n’y figure.
- Application de la directive noindex :
- Pour les pages HTML : Retirez la directive
Disallowdu robots.txt pour les URL spécifiques concernées. Permettez à Googlebot de crawler ces pages, puis ajoutez la balise<meta name="robots" content="noindex, follow">dans la section<head>de chaque page. Lefollowpermet à Google de suivre les liens présents sur la page, ce qui peut être utile si ces pages contiennent des liens vers d’autres contenus importants. - Pour les PDF, images et autres ressources non-HTML : Configurez l’en-tête HTTP
X-Robots-Tag: noindexvia votre serveur (Apache, Nginx) ou votre CMS. Par exemple, pour Apache, vous pouvez ajouter une ligne dans votre fichier.htaccess:<FilesMatch "\.(pdf|jpg|png)$"> Header set X-Robots-Tag "noindex, nofollow" </FilesMatch>.
- Pour les pages HTML : Retirez la directive
- Nettoyage des liens internes :
- Supprimez tous les liens internes pointant vers les pages que vous souhaitez désindexer.
- Si la suppression n’est pas possible ou souhaitable, ajoutez l’attribut
rel="nofollow"à ces liens pour indiquer à Google de ne pas les suivre et de ne pas transmettre de “jus de lien”.
- Mise à jour du sitemap XML :
- Assurez-vous que toutes les URL que vous souhaitez désindexer sont retirées de votre sitemap XML.
- Soumettez le sitemap mis à jour à Google via GSC.
- Demande de suppression d’URL (mesure temporaire) :
- Utilisez l’outil de suppression d’URL dans Google Search Console pour accélérer la désindexation des pages déjà présentes dans l’index. C’est une mesure temporaire (environ 6 mois), mais elle est utile pour un nettoyage rapide en attendant que Googlebot revisite les pages avec la directive noindex.
- Vérification post-correction :
- Surveillez le rapport « Pages » de Google Search Console pendant 2 à 4 semaines. Le statut des URL devrait passer de « Indexée malgré le blocage par le fichier robots.txt » à « Exclue par la balise ‘noindex’ » ou disparaître de l’index.
- Utilisez l’outil d’inspection d’URL pour vérifier que Googlebot peut désormais accéder à la page et lire la balise noindex.
Correction par plateforme : WordPress, Joomla et autres CMS
Chaque CMS offre des méthodes spécifiques pour implémenter ces directives. Voici quelques exemples :
WordPress
- Plugins SEO : Des plugins comme Yoast SEO ou Rank Math permettent de gérer facilement la balise
noindexpour les articles, pages, catégories, tags, etc. Vous trouverez l’option dans les réglages de chaque contenu ou dans les réglages généraux du plugin. - robots.txt : WordPress génère un fichier robots.txt virtuel. Pour le modifier, utilisez un plugin dédié (comme “WP Robots Txt”) ou ajoutez des règles via le fichier
.htaccesssi vous avez un accès serveur. - Fichiers média (PDF, images) : Pour appliquer le
X-Robots-Tag: noindexaux fichiers média, vous devrez généralement modifier le fichier.htaccessde votre serveur (pour Apache) ou la configuration Nginx.
Joomla!
- Réglages globaux et de menu : Joomla! permet de définir des balises meta robots (index/noindex, follow/nofollow) au niveau global de votre site, pour chaque élément de menu, ou même pour des articles spécifiques.
- Extensions SEO : Des extensions tierces offrent un contrôle plus granulaire sur les balises meta et la gestion du robots.txt.
Autres CMS ou sites statiques
- Modification directe du code : Pour les sites HTML statiques ou les CMS sans gestion intégrée, vous devrez éditer manuellement le code HTML de chaque page pour ajouter la balise
<meta name="robots" content="noindex">dans le<head>. - Configuration serveur : L’en-tête HTTP
X-Robots-Tag: noindexest configuré directement au niveau du serveur web (Apache, Nginx, IIS) via leurs fichiers de configuration respectifs (.htaccesspour Apache,nginx.confpour Nginx, etc.).
Maîtriser l’indexation de votre site est fondamental pour une stratégie SEO réussie. Ne laissez pas des pages indésirables diluer la valeur de votre site aux yeux de Google. Une action rapide et méthodique est essentielle pour garantir que seules les pages pertinentes et de qualité soient visibles dans les résultats de recherche.
Le SEO a désormais un complément, le GEO (Generative Engine Optimization), qui vise à faire recommander votre site par les moteurs de réponse IA. Comprendre le GEO.
Résultats vérifiables
La preuve par les chiffres
Voici l'évolution réelle du trafic organique de sites que j'accompagne, mesurée par Semrush. Pas de promesses : des courbes.
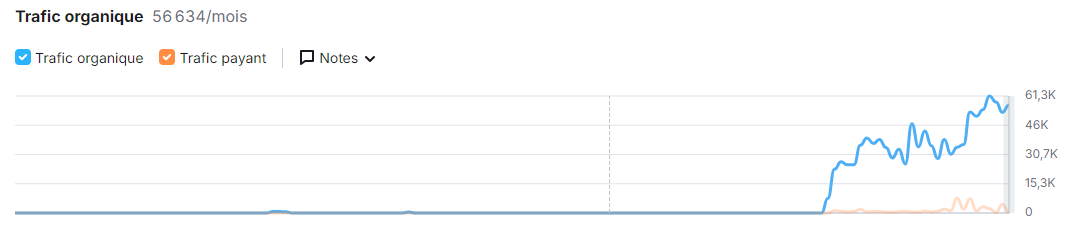
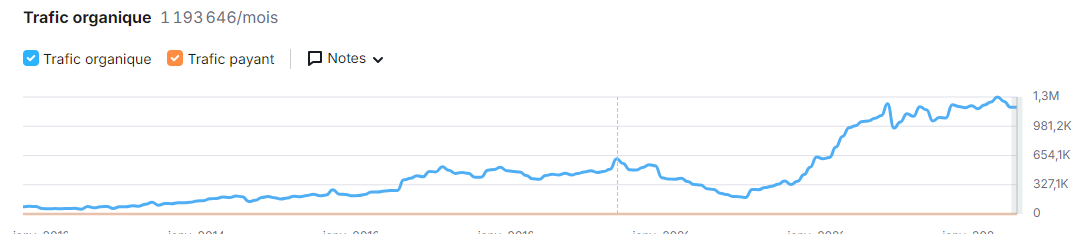
+1,2M
de visites organiques mensuelles générées
×3
de croissance sur un site déjà établi
0 €
de publicité : 100 % trafic organique
Captures Semrush disponibles sur demande, données anonymisées par respect de mes clients.
Analyse personnalisée, sans engagement, réponse sous 24 h, diagnostic gratuit sous 48 h avec 3–5 quick wins concrets.
Plus de 150 entrepreneurs m’ont déjà fait confiance
🔒 Vos données ne sont jamais partagées avec des tiers


José Perez, consultant SEO indépendant basé près de Rennes (Ille-et-Vilaine) depuis 2007, spécialisé en SEO technique et e-commerce. Il intervient en Bretagne et partout en France.
Tous les articles de José PEREZ →